Extract texte de un PDF en ligne
Pull tous selectable texte dehors de un PDF — copier il ou télécharger comme.txt.
Dernière mise à jour :
Extract texte de PDF en ligne
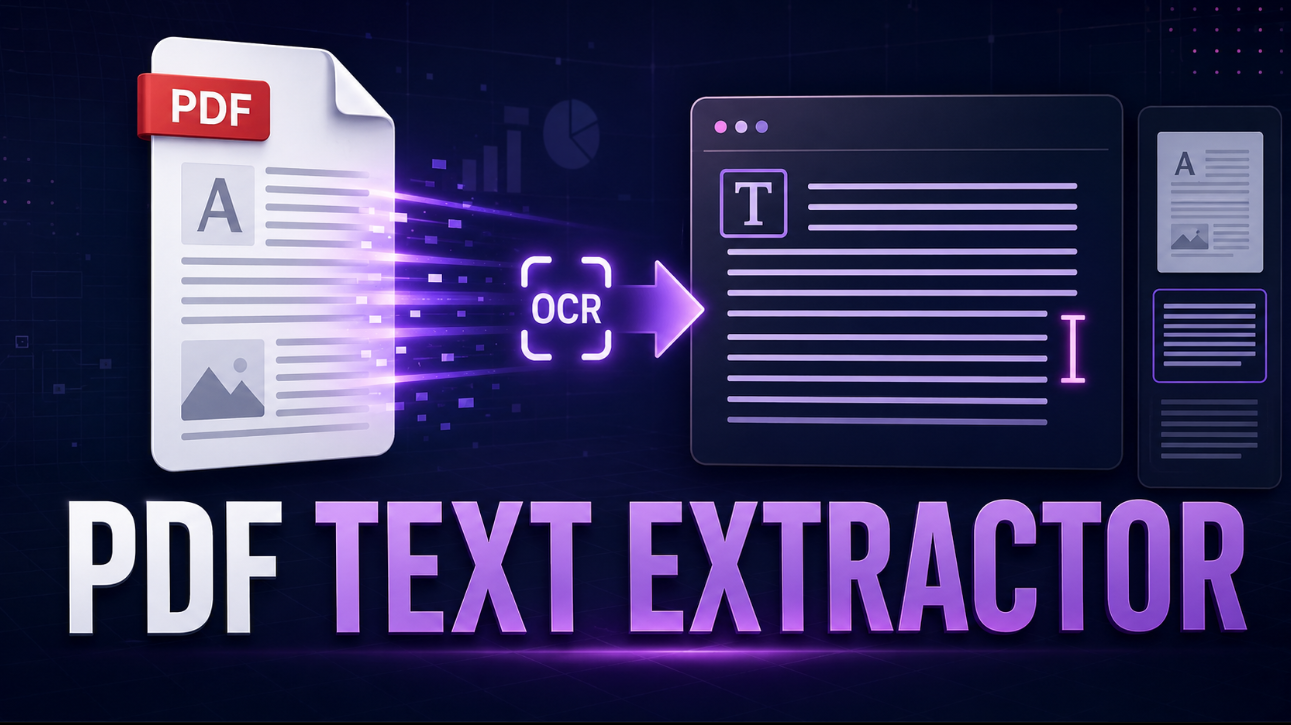
utiliser ce PDF texte extractor à turn PDF documents dans editable, searchable texte. téléverser un regular PDF avec selectable texte ou un numérisé document que a besoin de OCR, choisir le pages vous besoin, et réviser le extracted contenu avant copier ou télécharger il.
il est utile pour research papier, rapports, factures, manuel, formulaires, worksheets, et autre documents vous propre ou sont autorisé à processus. à la place de manuellement retyping texte, vous peut extract il page par page et faire corrections directement dans le aperçu.
comment à extract texte de un PDF
- téléverser ou drag et drop votre PDF fichier.
- sélectionner tous pages ou saisir un page plage, tel comme
3-8, 10. - choisir automatique OCR, toujours utiliser OCR, ou embedded-texte extraction seulement.
- sélectionner le OCR language pour numérisé documents.
- Extract le texte et réviser il dans le editable aperçu.
- copier tous texte ou télécharger le résultat comme un TXT fichier.
le outil preserves page separators donc vous peut voir où chaque section de texte came de.
texte-basé PDF vs. numérisé PDF
pas chaque PDF stores son texte dans le même façon.
texte-basé PDF
un texte-basé PDF contient embedded, selectable texte. ce est courant dans rapports, numérique manuel, exported documents, et research papier. le outil peut read ce texte directement, lequel est généralement plus rapide et plus précis que OCR.
numérisé PDF
un numérisé PDF est made de page images, tel comme numérisé pas, receipts, books, ou imprimer formulaires. parce que le texte est part de un image, il cannot normalement être sélectionné. OCR, ou optical caractère recognition, analyzes le page image et convertit visible caractères dans editable texte.
OCR est utile, mais il est pas perfect. petit texte, écriture manuscrite, unusual fonts, low-qualité scans, tables, formule, et blurred images peut produire recognition erreurs. toujours vérifier important noms, dates, référence nombres, et montant contre le original document.
Extract sélectionné pages seulement
vous faire pas besoin à extract chaque page de un long document. saisir un page plage quand vous seulement besoin un spécifique chapter, facture page, appendix, ou section.
Par exemple :
allextracts chaque page3-8extracts pages 3 via 81, 4, 7extracts individuel pages2-5, 9, 12-14combines multiples plage
Extracting seulement le pages vous besoin peut faire révision et organizing le texte plus facile.
Editable PDF texte aperçu
après extraction, le sortie apparaît dans un editable texte zone. vous peut correct OCR erreurs, supprimer unwanted ligne, ajouter pas, ou préparer le contenu pour translation, summarization, research, accessibility travail, ou écriture.
le télécharger TXT fichier reflects tout edits vous faire dans le aperçu.
supprimer repeated headers et footers
beaucoup PDF repeat le même document titre, page nombre, company name, ou footer sur chaque page. quand ce option est enabled, le outil vérifier pour repeated premier et dernier ligne dans multiples pages et supprimer eux où possible.
réviser le résultat après en utilisant ce option parce que un repeated ligne peut parfois être meaningful contenu.
confidentialité et document gérer
documents peut contenir confidential informations. ce outil processus PDF contenu dans votre navigateur pour texte extraction et OCR; le PDF itself est pas sent à un document-processus server par le outil.
seulement téléverser documents vous sont autorisé à accès et processus. éviter partage confidential fichiers sur public ou untrusted appareil, et claire le aperçu quand vous sont terminé.
courant PDF texte extraction utilise
- copier texte de research papier et académique articles
- convertir numérisé pas dans editable étude matériau
- Extract facture détails et report contenu
- préparer propre documents pour translation ou summarization
- faire document texte plus facile à utiliser avec screen readers
- Reuse autorisé manuel, formulaire, ou policy texte
- créer searchable pas de numérisé pages
- Export sélectionné PDF pages comme plain texte
PDF texte extractor FAQs
peut je extract texte de un numérisé PDF?
oui. sélectionner automatique OCR ou OCR pour chaque page. le outil utilise OCR quand un page fait pas contenir usable embedded texte.
pourquoi fait extracted texte parfois look différent de le PDF?
PDF peut utiliser columns, floating texte boxes, tables, headers, et unusual layouts. le extractor utilise un sensible ligne-basé lecture ordre où possible, mais complexe pages peut besoin manuel édition afterward.
peut je copier texte de un mot de passe-protected PDF?
vous peut saisir le mot de passe seulement quand vous sont autorisé à ouvrir le document. si le PDF cannot être ouvrir ou est damaged, le outil sera affichage un error.
peut je extract texte de seulement un quelques pages?
oui. utiliser un page plage tel comme 3-8 ou combine plage tel comme 1-3, 7, 10-12.
fait OCR guarantee perfect texte?
non. OCR accuracy dépend sur scan qualité, language, font, resolution, écriture manuscrite, et page layout. vérifier critical détails avant relying sur extracted texte.
quoi est le meilleur sortie format pour simple editable texte?
TXT est ideal pour propre, lightweight, searchable texte. vous peut ouvrir il dans Notepad, TextEdit, mot, Google Docs, ou la plupart écriture et research outils.