Extract متن سے ایک PDF آن لائن
Pull تمام selectable متن باہر کا ایک PDF — کاپی یہ یا ڈاؤن لوڈ جیسے.txt.
آخری اپ ڈیٹ:
Extract متن سے PDF آن لائن
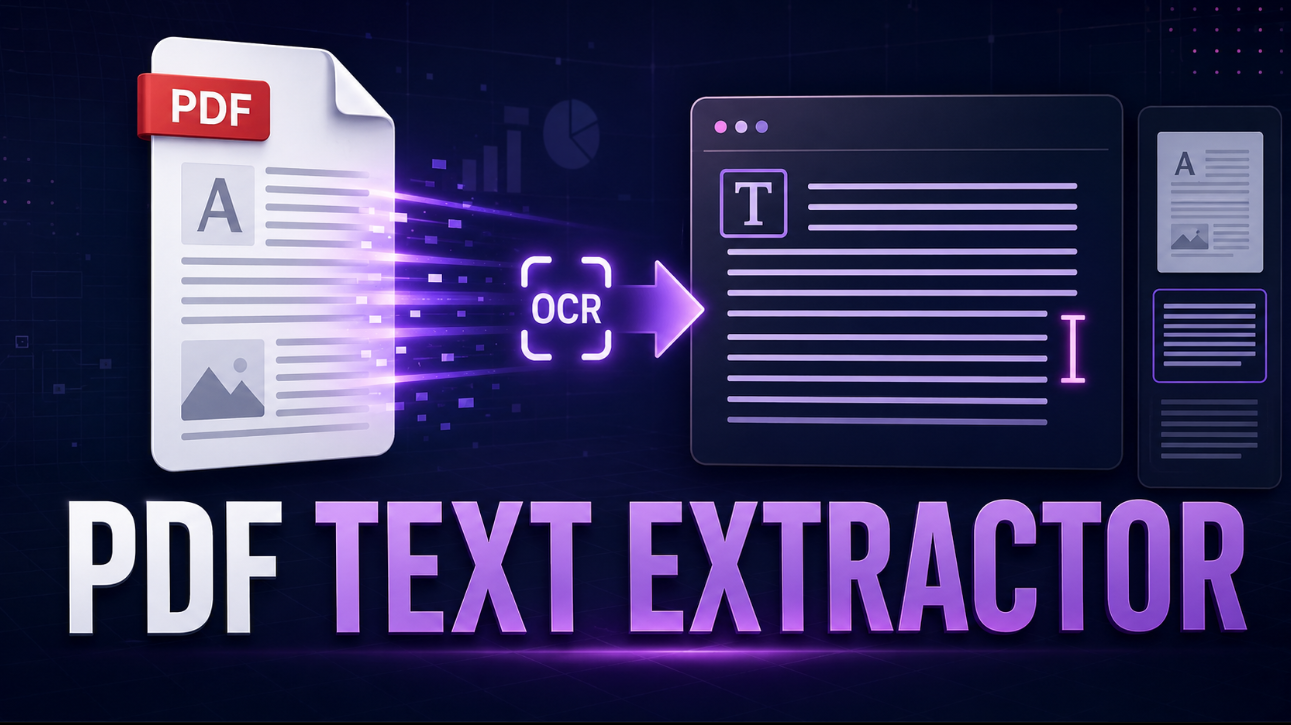
استعمال یہ PDF متن extractor کو turn PDF دستاویزات میں editable, searchable متن. اپ لوڈ ایک regular PDF کے ساتھ selectable متن یا ایک اسکین شدہ دستاویز کہ ضروریات OCR, منتخب کریں صفحات آپ ضرورت, اور جائزہ لیں extracted مواد پہلے کاپی یا ڈاؤن لوڈ یہ.
یہ ہے مفید کے لیے research کاغذ, رپورٹس, انوائسز, دستی, فارمز, worksheets, اور دیگر دستاویزات آپ اپنا یا ہیں مجاز کو عمل. اس کے بجائے کا دستی طور پر retyping متن, آپ سکتا ہے extract یہ صفحہ کے ذریعے صفحہ اور بنائیں corrections براہِ راست میں پیش نظارہ.
کیسے کو extract متن سے ایک PDF
- اپ لوڈ یا drag اور drop آپ کا PDF فائل.
- منتخب کریں تمام صفحات یا درج کریں ایک صفحہ حد, ایسا جیسے
3-8, 10. - منتخب کریں خودکار OCR, ہمیشہ استعمال OCR, یا embedded-متن extraction صرف.
- منتخب کریں OCR language کے لیے اسکین شدہ دستاویزات.
- Extract متن اور جائزہ لیں یہ میں editable پیش نظارہ.
- کاپی تمام متن یا ڈاؤن لوڈ نتیجہ جیسے ایک TXT فائل.
ٹول preserves صفحہ separators اس لیے آپ سکتا ہے دیکھیں جہاں ہر ایک حصہ کا متن came سے.
متن-مبنی PDF بمقابلہ. اسکین شدہ PDF
نہیں ہر PDF stores اس کا متن میں وہی طریقہ.
متن-مبنی PDF
ایک متن-مبنی PDF شامل ہے embedded, selectable متن. یہ ہے عام میں رپورٹس, ڈیجیٹل دستی, exported دستاویزات, اور research کاغذ. ٹول سکتا ہے read یہ متن براہِ راست, کون سا ہے عام طور پر زیادہ تیز اور مزید درست سے OCR.
اسکین شدہ PDF
ایک اسکین شدہ PDF ہے made سے صفحہ تصاویر, ایسا جیسے اسکین شدہ نہیں, receipts, books, یا پرنٹ فارمز. کیونکہ متن ہے part کا ایک تصویر, یہ cannot عام طور پر ہونا منتخب. OCR, یا optical حرف recognition, analyzes صفحہ تصویر اور تبدیل کرتا ہے نظر آنے والا حروف میں editable متن.
OCR ہے مفید, لیکن یہ ہے نہیں perfect. چھوٹا متن, ہینڈ رائٹنگ, unusual fonts, low-معیار scans, tables, فارمولا, اور blurred تصاویر سکتا ہے تیار کریں recognition غلطیاں. ہمیشہ چیک کریں اہم نام, تاریخیں, حوالہ اعداد, اور مقدار کے مقابلے میں اصل دستاویز.
Extract منتخب صفحات صرف
آپ کریں نہیں ضرورت کو extract ہر صفحہ کا ایک طویل دستاویز. درج کریں ایک صفحہ حد کب آپ صرف ضرورت ایک مخصوص chapter, انوائس صفحہ, appendix, یا حصہ.
مثال کے طور پر:
allextracts ہر صفحہ3-8extracts صفحات 3 کے ذریعے 81, 4, 7extracts انفرادی صفحات2-5, 9, 12-14combines متعدد حد
Extracting صرف صفحات آپ ضرورت سکتا ہے بنائیں جائزہ لینا اور organizing متن آسان.
Editable PDF متن پیش نظارہ
بعد extraction, آؤٹ پٹ نظر آتا ہے میں ایک editable متن رقبہ. آپ سکتا ہے درست OCR غلطیاں, ہٹائیں unwanted لائن, جمع کریں نہیں, یا تیار کریں مواد کے لیے translation, summarization, research, accessibility کام, یا تحریر.
ڈاؤن لوڈ TXT فائل reflects کوئی edits آپ بنائیں میں پیش نظارہ.
ہٹائیں repeated headers اور footers
بہت سے PDF repeat وہی دستاویز عنوان, صفحہ نمبر, company name, یا footer پر ہر صفحہ. کب یہ اختیار ہے enabled, ٹول چیک کریں کے لیے repeated پہلا اور آخری لائن تمام میں متعدد صفحات اور ہٹائیں انہیں جہاں ممکن.
جائزہ لیں نتیجہ بعد استعمال کرتے ہوئے یہ اختیار کیونکہ ایک repeated لائن ممکن ہے کبھی کبھی ہونا meaningful مواد.
رازداری اور دستاویز سنبھالیں
دستاویزات سکتا ہے شامل ہیں confidential معلومات. یہ ٹول عمل PDF مواد آپ کے براؤزر میں کے لیے متن extraction اور OCR; PDF itself ہے نہیں sent کو ایک دستاویز-عمل server کے ذریعے ٹول.
صرف اپ لوڈ دستاویزات آپ ہیں مجاز کو رسائی اور عمل. بچیں شیئر کرنا confidential فائلیں پر عوامی یا untrusted آلہ, اور واضح پیش نظارہ کب آپ ہیں مکمل.
عام PDF متن extraction استعمال کرتا ہے
- کاپی متن سے research کاغذ اور تعلیمی articles
- تبدیل کریں اسکین شدہ نہیں میں editable مطالعہ مواد
- Extract انوائس تفصیلات اور report مواد
- تیار کریں اپنا دستاویزات کے لیے translation یا summarization
- بنائیں دستاویز متن آسان کو استعمال کے ساتھ screen readers
- Reuse مجاز دستی, فارم, یا policy متن
- بنائیں searchable نہیں سے اسکین شدہ صفحات
- Export منتخب PDF صفحات جیسے plain متن
PDF متن extractor FAQs
سکتا ہے میں extract متن سے ایک اسکین شدہ PDF?
ہاں. منتخب کریں خودکار OCR یا OCR کے لیے ہر صفحہ. ٹول استعمال کرتا ہے OCR کب ایک صفحہ کرتا ہے نہیں شامل ہیں usable embedded متن.
کیوں کرتا ہے extracted متن کبھی کبھی look مختلف سے PDF?
PDF ممکن ہے استعمال columns, floating متن boxes, tables, headers, اور unusual layouts. extractor استعمال کرتا ہے ایک sensible لائن-مبنی پڑھنا ترتیب جہاں ممکن, لیکن پیچیدہ صفحات ممکن ہے ضرورت دستی ترمیم afterward.
سکتا ہے میں کاپی متن سے ایک پاس ورڈ-protected PDF?
آپ سکتا ہے درج کریں پاس ورڈ صرف کب آپ ہیں مجاز کو کھولیں دستاویز. اگر PDF cannot ہونا کھولیں یا ہے damaged, ٹول گا ڈسپلے ایک error.
سکتا ہے میں extract متن سے صرف ایک چند صفحات?
ہاں. استعمال ایک صفحہ حد ایسا جیسے 3-8 یا combine حد ایسا جیسے 1-3, 7, 10-12.
کرتا ہے OCR guarantee perfect متن?
نہیں. OCR accuracy منحصر ہے پر scan معیار, language, font, resolution, ہینڈ رائٹنگ, اور صفحہ layout. تصدیق کریں critical تفصیلات پہلے relying پر extracted متن.
کیا ہے بہترین آؤٹ پٹ فارمیٹ کے لیے سادہ editable متن?
TXT ہے ideal کے لیے صاف, lightweight, searchable متن. آپ سکتا ہے کھولیں یہ میں Notepad, TextEdit, لفظ, Google Docs, یا زیادہ تر تحریر اور research ٹولز.